Actualidad IA y guías para construir agentes
Seguimos modelos, benchmarks, plataformas y buenas prácticas, pero lo traducimos a decisiones concretas para agentes reales.
Página 47
822 artículos
WildClawBench pone a los agentes a trabajar de verdad: tareas largas, tools reales y ningun modelo pasa del 63%
WildClawBench aparecio el 11 de mayo de 2026 como benchmark de 60 tareas largas y multimodales corriendo dentro de runtimes CLI reales como OpenClaw, Claude Code, Codex y Hermes Agent. La lectura útil para builders es brutal: cambiar de harness puede mover hasta 18 puntos y ni el lider rompe el 63%.
JetBrains abre Mellum2: un modelo rapido para subagentes, RAG y coding sin pagar latencia de frontier
JetBrains publico Mellum2 el 1 de junio de 2026 como modelo open-weight de 12B con 2.5B parametros activos por token, licencia Apache 2.0 y foco en tareas rápidas de pipeline como routing, RAG, tool use y coding. La lectura útil para builders no es reemplazar al modelo grande: es sacar del camino el trabajo que no necesita uno.
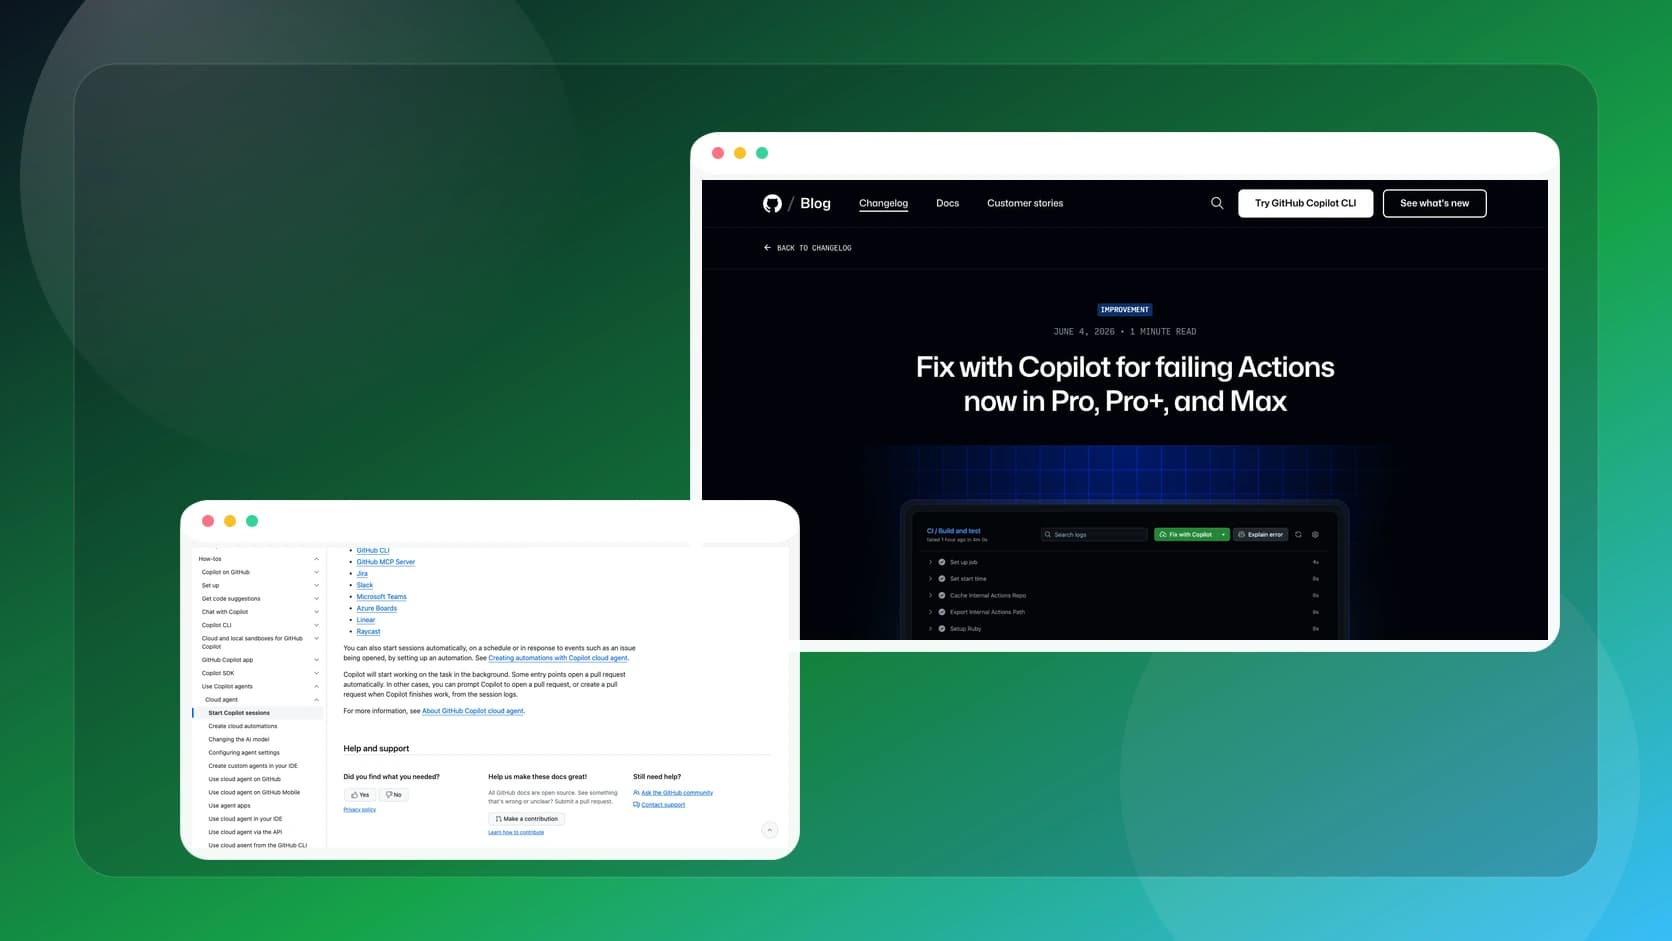
GitHub deja que Copilot arregle Actions rotos en planes Pro y Max: cuando si ahorra tiempo y cuando solo te maquilla el problema
GitHub extendio el 4 de junio de 2026 la funcion Fix with Copilot para workflows fallidos de GitHub Actions a Copilot Pro, Pro+ y Max. La novedad útil para builders no es el boton: es poder delegar fallas repetitivas desde los logs hacia un agente en nube con PR y revision.
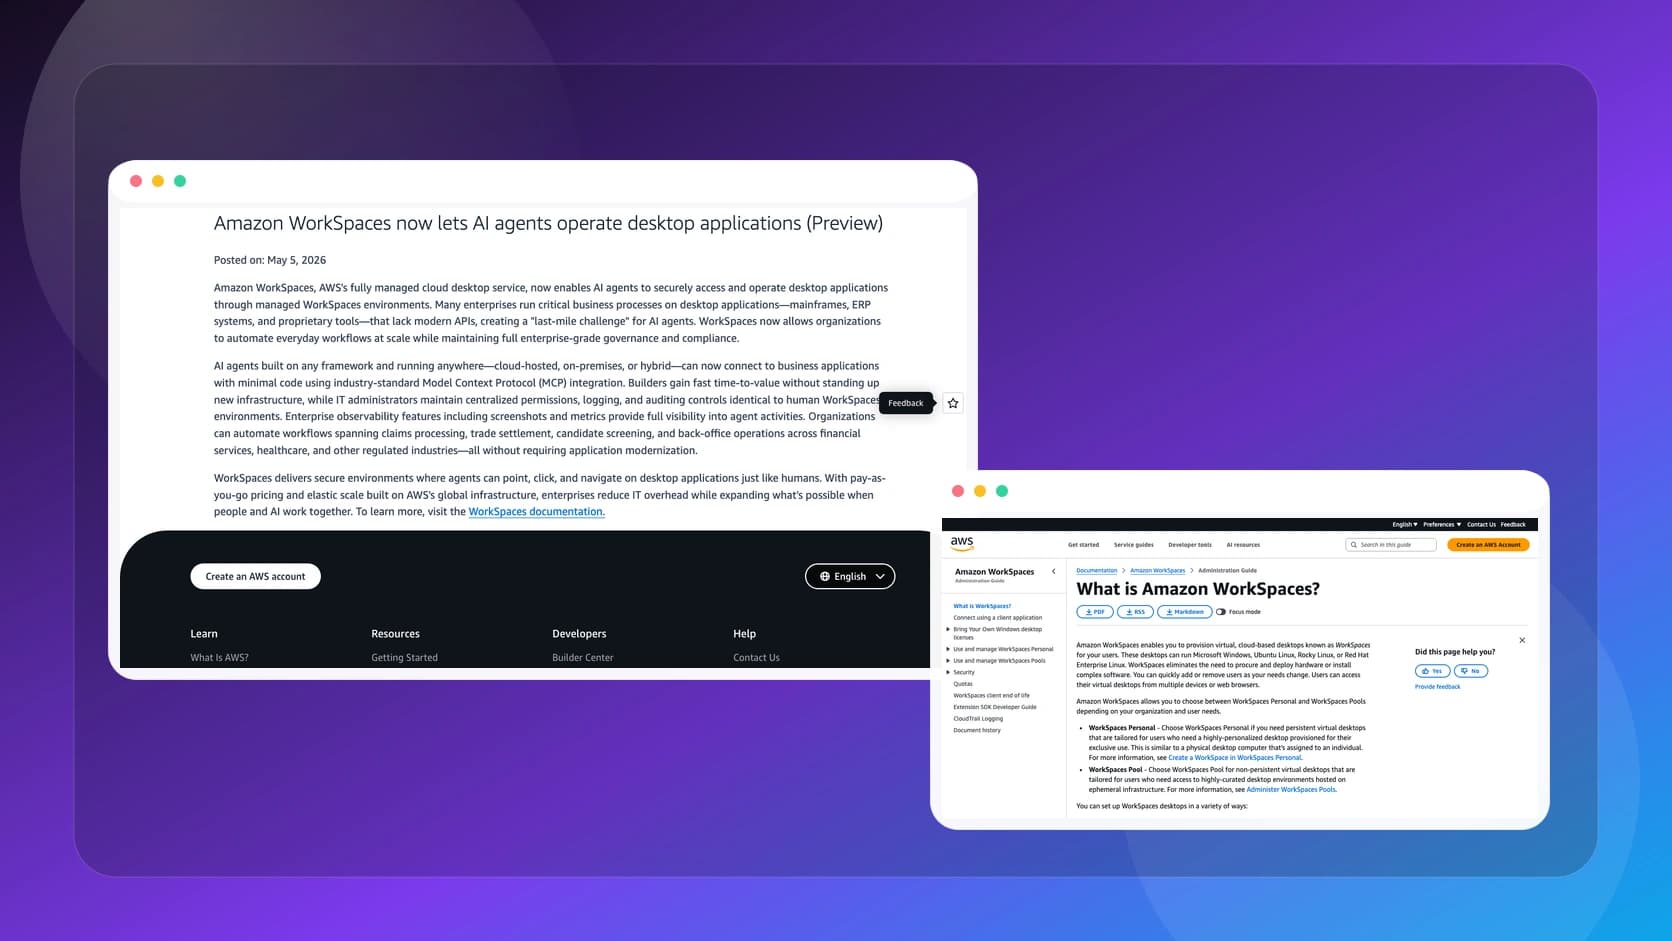
Amazon WorkSpaces deja que agentes operen apps de escritorio: donde si resuelve el último kilometro y donde sigue oliendo a riesgo
AWS anuncio el 5 de mayo de 2026 que Amazon WorkSpaces ahora deja a agentes de IA usar aplicaciones de escritorio dentro de escritorios gestionados. La novedad fuerte para builders no es otro demo de computer use: es una ruta enterprise para automatizar software sin APIs modernas.
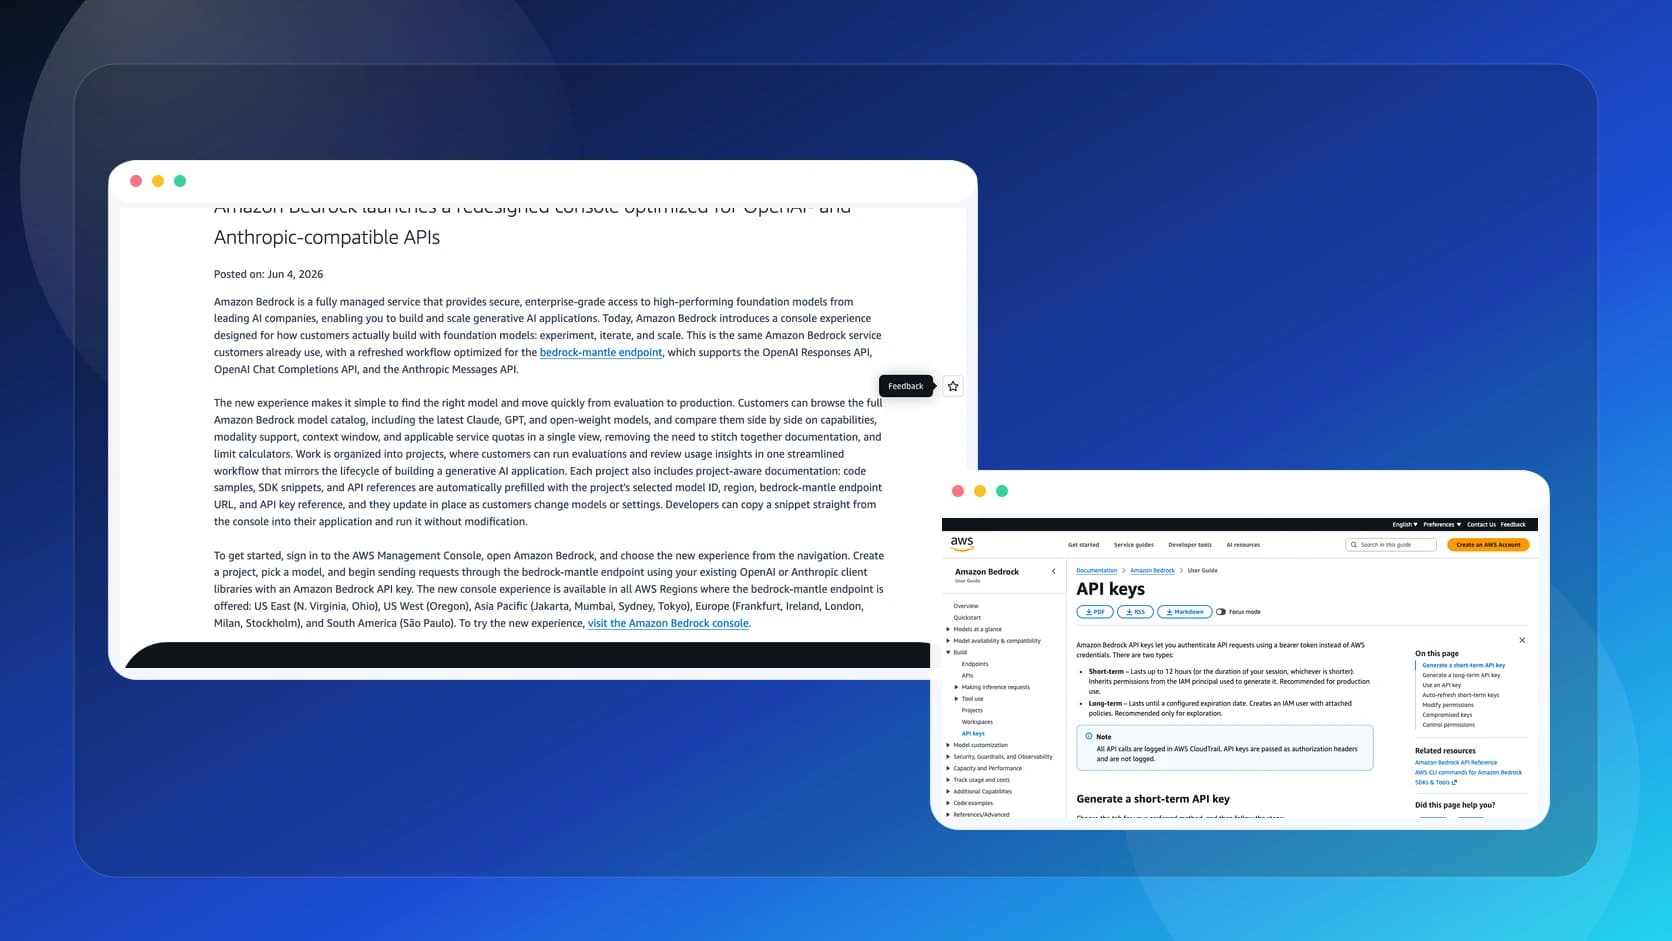
Amazon Bedrock rediseña su consola para APIs compatibles con OpenAI y Anthropic: donde si ahorra tiempo y donde no
AWS anuncio el 4 de junio de 2026 una consola nueva para Bedrock pensada alrededor de APIs compatibles con OpenAI y Anthropic. La mejora útil para builders no es la UI bonita: es reducir el trabajo manual entre elegir modelo, generar snippets y mover un experimento hacia producción.
Vercel endurece la letra chica de los agentes: quien paga y quien responde cuando una automation se equivoca
Vercel actualizo sus terminos el 4 de junio de 2026 para dejar explicita la responsabilidad sobre AI Functionality y Third-Party Tools. La lectura útil para builders es pragmatica: si conectas agentes o scripts a tu cuenta, el alcance, los costos y la revision ya no son ambiguedades.
GitHub Copilot ya deja subir contexto y razonamiento: cuando sirve y cuando solo quema créditos
GitHub anuncio el 4 de junio de 2026 ventanas de contexto de hasta un millon de tokens y reasoning levels configurables para Copilot. La utilidad real para builders no es el número grande: es elegir cuando una tarea necesita profundidad y cuando solo conviene no disparar costo ni latencia.
Kaggle baja los benchmarks al IDE: por que esto si cambia como builders miden agentes
Kaggle anuncio el 4 de junio de 2026 desarrollo local para Benchmarks y un skill para coding agents. La novedad útil no es otra leaderboard: es poder escribir, validar y correr evals desde VS Code, Cursor o Antigravity sin quedarse encerrado en el notebook web.
Vercel mete Sandbox dentro del CLI: menos cambió de contexto para agentes que si verifican
Vercel anuncio el 8 de abril de 2026 que Sandbox ya se gestiona desde `vercel sandbox`. Para builders, la mejora real es unir runtime aislado, red y dev server dentro del mismo loop de terminal.
Gemini API suma Flex y Priority: como elegir costo o confiabilidad sin partir tu arquitectura de agentes
Google agrego el 2 de abril de 2026 los tiers Flex y Priority para Gemini API. La novedad importa porque deja rutear trabajo de agentes por criticidad sin separar todo entre sync, batch y remiendos propios.
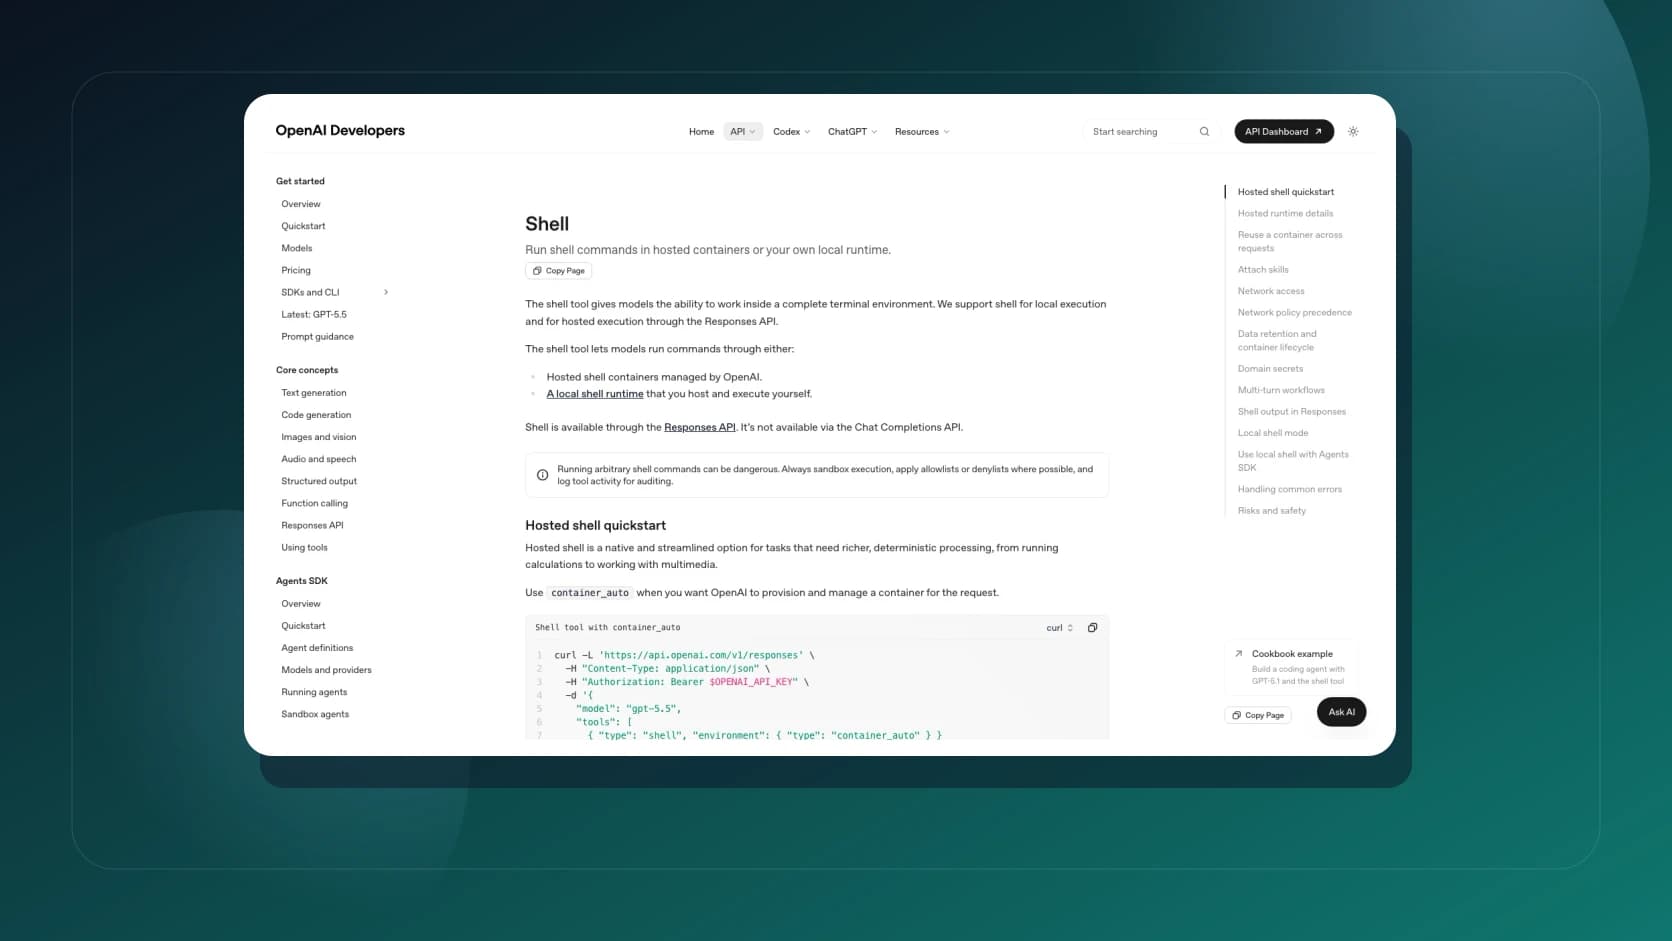
OpenAI baja un computer environment a la Responses API: por que esto cambia más que otro tool para agentes
OpenAI explico el 11 de marzo de 2026 como equipa la Responses API con shell, contenedor hospedado, compaction y red controlada. La noticia real para builders es que el loop de agente deja de depender de pegamento casero.
ITBench-AA deja una mala noticia útil para builders: ni los mejores agentes pasan del 50% en incidentes SRE
Artificial Analysis e IBM publicaron el 27 de mayo de 2026 ITBench-AA, un benchmark para tareas agentic de IT empresarial donde los modelos frontier quedan por debajo del 50% en diagnostico SRE sobre snapshots reales de Kubernetes. La señal útil no es quien gana la tabla: es que los agentes todavía fallan bastante cuando el problema exige logs, trazas y precision de causa raiz.
AWS Agent Toolkit ya reemplaza a sus MCP viejos: skills evaluadas, servidor administrado y plugins para que Codex no improvise
AWS lanzó el 6 de mayo de 2026 Agent Toolkit for AWS como sucesor de sus MCP servers, plugins y skills de AWS Labs. La señal útil para builders no es otra caja de herramientas: es que AWS esta empaquetando conocimiento validado, guardrails IAM y observabilidad para bajar errores, tokens perdidos y workflows improvisados.
GitHub Copilot app sale del nicho preview: canvases, worktrees paralelos y automatizaciones en nube para trabajo agentic serio
GitHub amplio el 2 de junio de 2026 el technical preview de Copilot app y movió su centro de gravedad hacia canvases, sesiones paralelas con worktrees aislados, cloud sessions y agentic browsing. La señal útil para builders no es otra interfaz: es que GitHub ya empaqueta el loop entero de pedir, revisar, verificar y volver a correr agentes.
MAI-Transcribe 1.5 aprieta la economía de voz para agentes: más velocidad, 43 idiomas y menos presupuesto perdido en esperar
Microsoft destapo MAI-Transcribe 1.5 en Build 2026 y Artificial Analysis lo ubicó entre los lideres por velocidad y precision. La mejora útil para builders de voz no es solo otra transcripcion: es liberar más tiempo del budget para razonamiento, tools y respuesta.