Actualidad IA y guías para construir agentes
Seguimos modelos, benchmarks, plataformas y buenas prácticas, pero lo traducimos a decisiones concretas para agentes reales.
Página 46
822 artículos
Vercel Sandbox añade Drives: cuándo sí resuelven workspaces largos y cuándo siguen ganando los snapshots
Vercel lanzó Drives para Sandbox en private beta el 5 de junio de 2026. La novedad útil no es solo guardar archivos: es separar caché, workspace y estado compartido del ciclo de vida del sandbox para agentes que vuelven al mismo trabajo.
Cloudflare Artifacts propone Git para agentes: repos por tarea, forks rápidos y menos estado improvisado
Cloudflare lanzó Artifacts el 16 de abril de 2026 como almacenamiento versionado compatible con Git para agentes y automatizaciones. La señal útil no es otra capa de storage: es separar sesiones, ramas y handoffs sin pegar bases de datos, blobs y workspaces efímeros a la fuerza.
GitHub Copilot en Visual Studio 2026 gira hacia plan, skills y diffs largos: menos chat y más flujo operable
GitHub publicó el 4 de junio de 2026 la actualización de mayo para Copilot en Visual Studio 2026. Lo útil no es una sola feature: es que el IDE ya separa mejor planificación, skills reutilizables y revisión multiarchivo antes de tocar código.
EVA-Bench Data 2.0 sube la vara para agentes de voz: 3 dominios, 121 tools y 213 escenarios
ServiceNow AI publicó EVA-Bench Data 2.0 el 4 de junio de 2026 en Hugging Face. La novedad útil no es otra tabla de resultados: es una base más sería para evaluar agentes de voz que sí usan herramientas, políticas y contextos de negocio reales.
Hugging Face rediseña `hf` CLI para agentes: menos tokens desperdiciados y menos pegamento sobre el Hub
Hugging Face publicó el 4 de junio de 2026 un rediseño de `hf` CLI pensado para Codex, Claude Code y otros agentes. La señal útil no es otra herramienta más: es que el Hub ya empieza a optimizarse para agentes como usuario de primera clase.
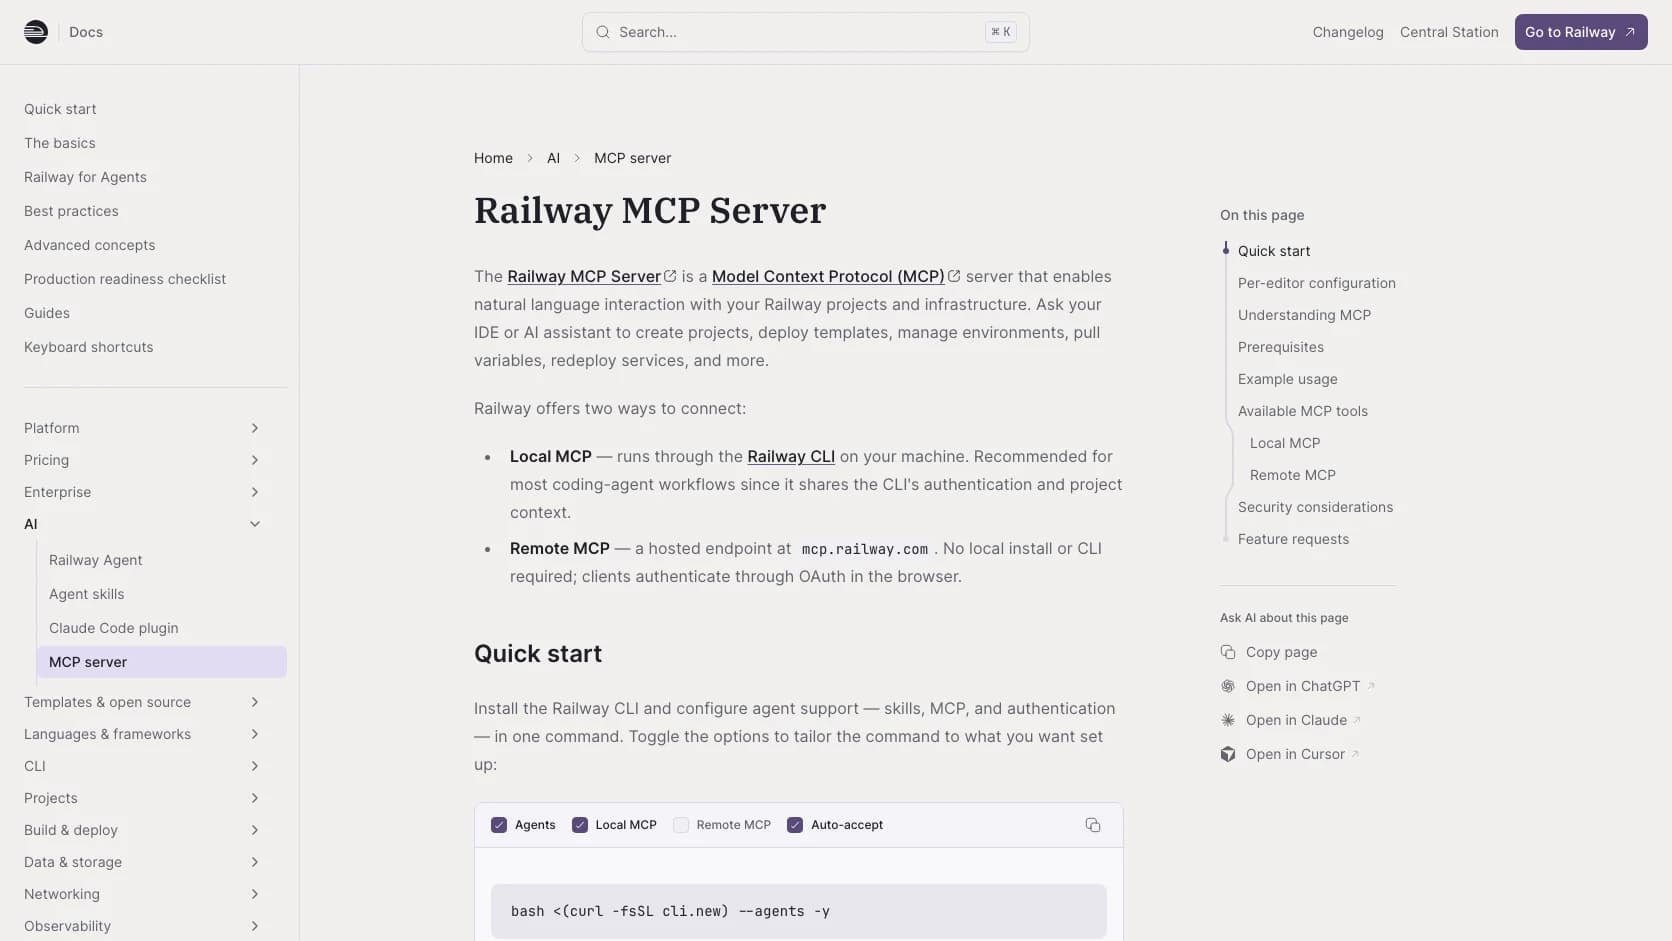
Railway empaqueta remote MCP y setup agent: menos config manual para desplegar con Codex o Claude Code
Railway activo su remote MCP server el 17 de abril de 2026 y desde mayo documenta `railway setup agent` para instalar skills y configurar clientes compatibles. La novedad útil no es otro MCP: es reducir la friccion real entre agente de coding y deploy.
Sentry convierte traces en conversaciones legibles: por que eso si cambia depurar agentes
Sentry abrió AI Conversations en beta el 21 de mayo de 2026 para reorganizar mensajes, tool calls y respuestas en una linea de tiempo leible. La novedad útil no es otra vista bonita: es por fin poder revisar sesiones agenticas sin perderse entre spans.
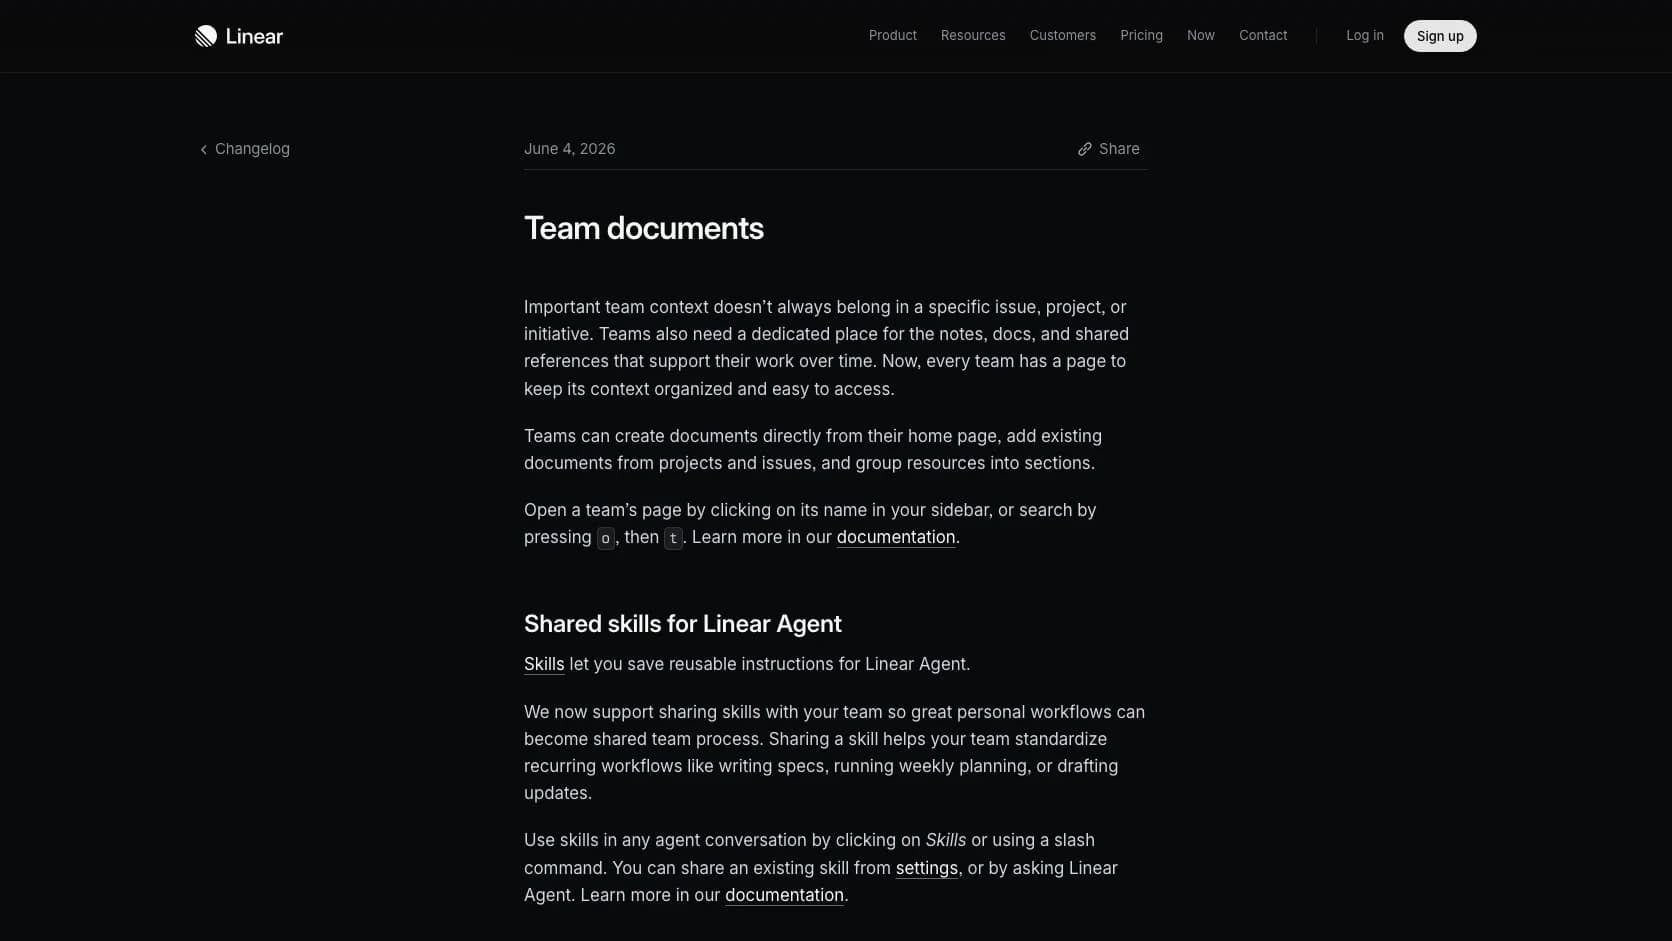
Linear ya comparte skills entre equipos: menos prompts privados y más proceso reutilizable
Linear anuncio el 4 de junio de 2026 que Linear Agent ya puede compartir skills con todo el equipo. La novedad útil no es solo guardar prompts: es empezar a convertir specs, weekly planning y updates repetibles en proceso visible y reusable.
SageMaker mete multi-turn RL para agentes: como afinar modelos pequenos contra tareas reales y no solo contra prompts sueltos
AWS anuncio el 3 de junio de 2026 que SageMaker AI ya soporta multi-turn reinforcement learning para personalizacion de modelos agenticos. La parte fuerte para builders no es otra técnica de tuning: es entrenar contra secuencias completas de decisiones usando tu propio entorno de herramientas.
Azure Cosmos DB MCP Toolkit ya esta en GA: ocho tools, Foundry en dos clics y menos friccion para conectar datos reales a tus agentes
Microsoft anuncio el 2 de junio de 2026 la disponibilidad general del Azure Cosmos DB MCP Toolkit. La diferencia útil para builders no es otro wrapper de base de datos: es conectar agentes a datos operativos y vectoriales con RBAC, transport HTTP estable e integración directa con Foundry.
LogRocket abre su MCP a todos: sesiones reales, metricas y tickets para que tu agente deje de debuggear a ciegas
LogRocket anuncio el 2 de junio de 2026 que su MCP ya esta disponible para todos. La parte útil para builders no es otro conector: es meter reproducciones reales, issues y metricas dentro del loop de Claude, Codex o Cursor antes de tocar codigo.
RAMP pone a los agentes a construir un compilador y casi todos se caen: por que este benchmark merece más atencion
RAMP reaparecio en la conversacion de builders el 4 de junio de 2026 con un benchmark de seis etapas seriales sobre un compilador real. La noticia no es otro scoreboard: es mostrar como se derrumban los agentes cuando hay estado persistente, dependencias y costos reales.
Codex 0.137.0 mete créditos, permisos por entorno y plugins más legibles: por que eso si cambia operaciones
OpenAI publico Codex 0.137.0 el 4 de junio de 2026 con limites mensuales de créditos para enterprise, permisos con identidad de entorno, `codex plugin list --json` y mejoras para multiagente. La noticia no es el TUI: es gobernar mejor sesiones reales.
Claude Code v2.1.152 endurece skills y hooks: menos herramientas por defecto, menos sesiones rotas
Anthropic publico Claude Code v2.1.152 el 27 de mayo de 2026 con `disallowed-tools` para skills, recarga de skills en caliente, hooks nuevos y fallback model de sesion. La señal útil para builders es control más fino sin reiniciar ni perder el hilo cuando el modelo falla.
EvoCode-Bench expone el punto debil de los coding agents: sobreviven peor cuando el requerimiento cambia
EvoCode-Bench se publico el 22 de mayo de 2026 con 26 tareas multi-turn y 227 rondas evaluadas para medir si un coding agent mantiene un workspace vivo sin romper requisitos previos. La señal útil para equipos es dura: el mejor score de una ronda aislada no coincide con el mejor score persistente, y los agentes fuertes también se desordenan cuando el trabajo evoluciona.